Pendahuluan: Melampaui Sekadar Menyusun Blok Lego
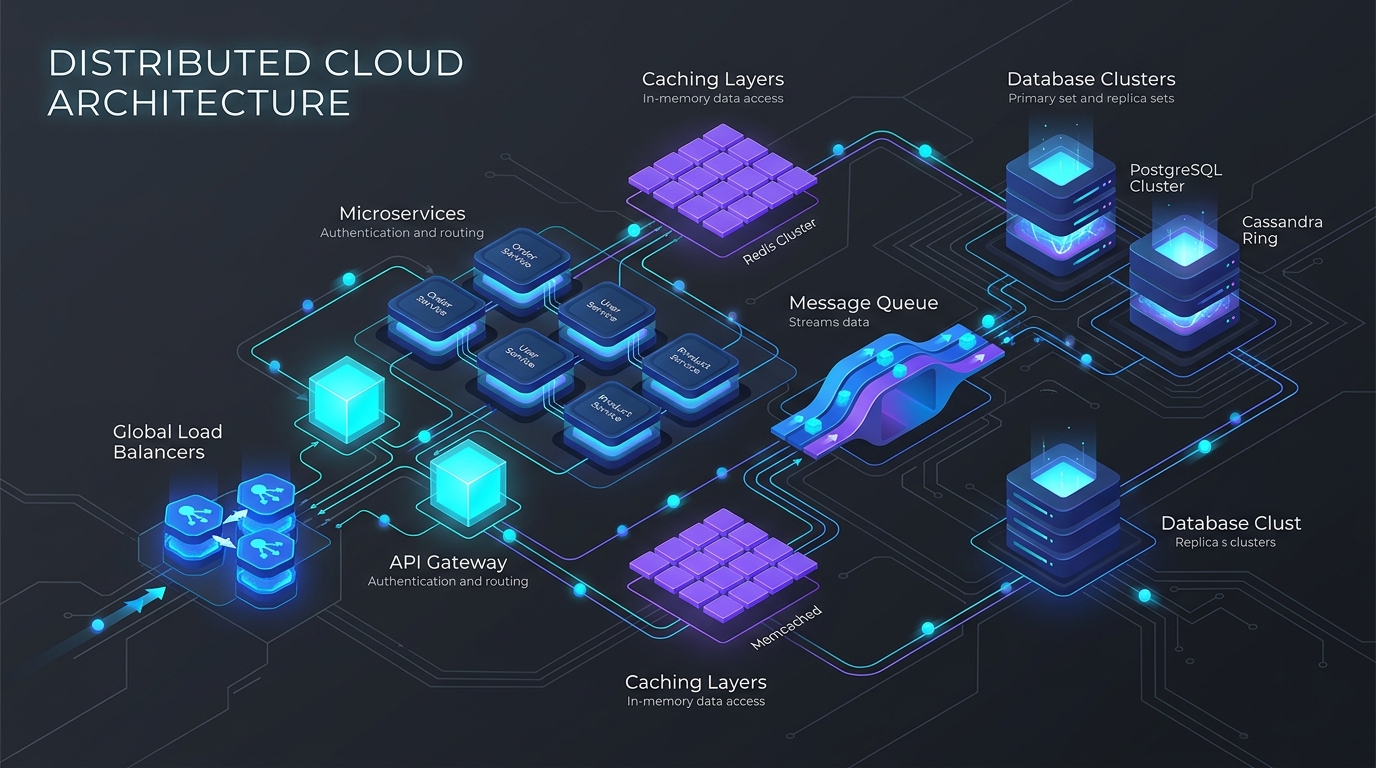
Pada Part 2: Komponen Inti Skalabilitas, kita telah memetakan komponen fisik skala besar: load balancer, cache memory, database cluster, dan message broker.
Namun, engineer level junior atau mid sering kali memperlakukan komponen tersebut seperti menyusun balok Lego sederhana—mengasumsikan bahwa menghubungkan Kafka ke PostgreSQL akan langsung bekerja mulus tanpa masalah. Sebaliknya, Senior dan Principal Engineer memahami kenyataan pahit di lapangan: dalam sistem terdistribusi, segala hal yang berpotensi rusak pasti akan rusak pada waktunya (chaos engineering).
Kabel optik bawah laut bisa putus akibat gempa bumi. Node server mendadak mati di tengah-tengah proses eksekusi transfer rekening bank. Request HTTP ganda datang di luar urutan aslinya. Disk database mendadak penuh di jam sibuk.
Untuk menembus wawancara System Design level senior, Anda harus membuktikan pemahaman mendalam tentang teori sistem terdistribusi dan pola arsitektur yang telah teruji dalam menghadapi situasi bencana.
1. Teorema CAP & Realitas Praktis Model PACELC
Dirumuskan oleh Eric Brewer pada tahun 2000, Teorema CAP menyatakan bahwa dalam sistem penyimpanan data terdistribusi yang asinkron, Anda hanya bisa menjamin dua dari tiga karakteristik berikut secara bersamaan:
                 Consistency (C)
                    ▲       ▲
                   /         \
                  /   RDBMS   \
                 /  (Single)   \
                /               \
Availability (A) ════════════════ Partition Tolerance (P)
        (DynamoDB, Cassandra)       (HBase, MongoDB, Spanner)
- Consistency (C): Setiap operasi baca selalu mengembalikan data penulisan terbaru atau mengembalikan pesan galat / error (Linearizability).
- Availability (A): Setiap node yang masih hidup selalu memberikan respons sukses non-error untuk setiap request (tanpa jaminan bahwa data tersebut adalah yang paling mutakhir).
- Partition Tolerance (P): Sistem tetap dapat beroperasi meskipun terjadi kehilangan pesan atau keterlambatan komunikasi antarnode akibat gangguan jaringan.
Fakta Nyata Wawancara: "CA" Adalah Mitos di Sistem Terdistribusi
Partisi jaringan (network partition) adalah keniscayaan fisik yang tidak bisa dihindari (kabel putus, switch router hang, lonjakan packet loss). Oleh sebab itu, Partition Tolerance (P) wajib dipenuhi.
Pilihan arsitektur nyata Anda selalu mengerucut pada CP atau AP:
- Sistem CP (Konsistensi di atas Ketersediaan): Jika Node 1 terputus dari Node 2, sistem akan menolak operasi tulis atau mengembalikan error daripada melayani data yang basi atau tidak sinkron. Contoh: Google Cloud Spanner, Apache HBase, MongoDB (dengan majority write concern), sistem buku besar bank.
- Sistem AP (Ketersediaan di atas Konsistensi): Jika terjadi pemutusan jaringan, kedua node tetap menerima operasi tulis dari pengguna secara terpisah. Sistem menerima ketidaksinkronan data sementara dan menyelesaikan konflik nantinya via eventual consistency. Contoh: Apache Cassandra, Amazon DynamoDB, Couchbase, sistem DNS.
Melampaui CAP: Teorema PACELC
Teorema CAP hanya menjelaskan perilaku sistem ketika terjadi partisi jaringan. Apa yang terjadi selama 99,9% kondisi jaringan normal tanpa gangguan?
Teorema PACELC oleh Daniel Abadi melengkapi gambaran tersebut:
Jika terjadi Partisi jaringan, pilih trade-off antara Availability vs Consistency; Else (jika kondisi normal), pilih trade-off antara Latency vs Consistency.
- PA/EL: Bila partisi terjadi, utamakan Availability; Dalam kondisi normal, korbankan strong consistency demi Latency yang super cepat (misalnya DynamoDB, Cassandra).
- PC/EC: Bila partisi terjadi, utamakan Consistency; Dalam kondisi normal, pertahankan Consistency ketat meskipun harus membayar biaya latency ekstra (misalnya PostgreSQL dengan replikasi sinkron, Bigtable).
2. Consistent Hashing: Mengurangi Lonjakan Eviksi pada Klaster Dinamis
Saat mendistribusikan jutaan kunci cache ke $N$ server Redis atau Memcached, rumus modulus sederhana terlihat sangat menggoda:
$$\text{Index Server} = \text{hash}(\text{key}) \pmod N$$
Bencana Algoritma Modulus Sederhana
Jika Anda memiliki 4 server ($N=4$) lalu menambahkan 1 server baru ($N=5$), angka pembagi berubah untuk hampir seluruh kunci data. Sekitar 80% dari seluruh kunci cache seketika terpetakan ke server yang salah! Hal ini memicu badai cache miss massal secara tiba-tiba di seluruh infrastruktur, membombardir database primer dan berujung pada kelumpuhan sistem total (cascading outage).
Cincin Hash Konsisten (Consistent Hashing Ring)
Consistent Hashing memetakan identitas server maupun kunci data ke atas sebuah Cincin Hash 32-bit melingkar ($0$ hingga $2^{32} - 1$):
                                  [ Server A ] (0)
                                     /       \
                                    /         \
                      [ Key 1 ] ───►           \
                                  /             \
                   [ Server C ]                  [ Server B ]
                   (2^32 * 0.66)                (2^32 * 0.33)
                                  \             /
                                   \           /
                     [ Key 2 ] ─────►         /
                                     \       /
- Nilai identitas server (misalnya IP address
Server-A) di-hash ke titik koordinat tertentu pada cincin. - Kunci data (misalnya
user_49102) di-hash ke koordinat pada cincin yang sama. - Untuk menentukan server mana yang menyimpan data tersebut, telusuri cincin searah jarum jam (clockwise) hingga menemukan server terdekat pertama.
Apa yang Terjadi Saat Server Ditambah atau Dihapus?
Ketika server baru disisipkan di antara Server A dan Server B, hanya kunci yang berada di antara Server A dan server baru tersebut yang berpindah lokasi. Kunci-kunci lain di seluruh penjuru cincin sama sekali tidak terpengaruh! Dengan $N$ node yang ada, penambahan atau pengurangan node rata-rata hanya memindahkan $1/N$ dari total seluruh kunci data.
Node Virtual (Virtual Nodes / Vnodes) Mencegah Beban Berat Sebelah
Pada cincin dasar, hasil hash server bisa tersebar tidak merata, menciptakan titik panas (hotspot) di mana satu server bisa menanggung 60% beban trafik.
Solusi: Petakan setiap server fisik ke ratusan Virtual Node (Vnodes) yang disebar acak di sepanjang cincin (misal Server-A#1, Server-A#2, ..., Server-A#200). Teknik ini meratakan distribusi beban data hingga variasi toleransi di bawah 2% dan memudahkan pemberian bobot kapasitas (mesin RAM 64GB diberi 200 vnodes, mesin RAM 32GB diberi 100 vnodes).
3. Sharding Database: Penskalaan Kapasitas Tulis Secara Horizontal
Ketika sebuah tabel database relasional melampaui puluhan juta baris, indeks B-Tree tidak lagi muat di memori RAM dan kapasitas IOPS disk mulai jenuh. Sharding (Partisi Horizontal) memecah satu tabel logis menjadi beberapa bagian yang disimpan pada instans database fisik yang terpisah.
Strategi Sharding Populer
- Range-Based Sharding:
- Merutekan data berdasarkan rentang nilai tertentu (misal Shard 1 memuat User ID
1s.d.1.000.000; Shard 2 memuat1.000.001s.d.2.000.000). - Risiko: Titik panas penulisan (write hotspot). Karena auto-increment ID selalu bertambah, 100% trafik penulisan data baru akan membebani shard tertinggi, sementara shard lama menganggur.
- Merutekan data berdasarkan rentang nilai tertentu (misal Shard 1 memuat User ID
- Directory-Based (Lookup) Sharding:
- Menyimpan tabel pemetaan terpusat
ID Entitas -> ID Shard. - Kelebihan: Fleksibilitas maksimal; pemindahan data antarspek shard dapat dilakukan dinamis.
- Risiko: Layanan lookup menjadi titik kegagalan tunggal (SPOF) dan menambah overhead latensi pada setiap kueri.
- Menyimpan tabel pemetaan terpusat
- Hash-Based Sharding (Standar Industri):
- Merutekan baris menggunakan rumus $\text{hash}(\text{ShardKey}) \pmod{\text{Jumlah Shard}}$.
- Kelebihan: Distribusi penulisan data tersebar merata ke seluruh node.
- Trade-off: Mengubah jumlah shard (resharding) memerlukan pipeline migrasi data latar belakang yang rumit.
Tantangan Rumit Sharding yang Wajib Dibahas dalam Wawancara:
- Cross-Shard Joins: Menjalankan kueri
JOINantartabel yang berada di server database fisik yang berbeda sangatlah lambat dan mahal. Solusi: Denormalisasi skema data, duplikasi tabel referensi statis di semua shard, atau lakukan join di level kode aplikasi. - Transaksi Terdistribusi: Mengubah data di beberapa shard sekaligus membutuhkan Two-Phase Commit (2PC) yang memicu latensi tinggi dan penguncian tabel. Solusi: Rancang Shard Key agar entitas yang saling berhubungan selalu berada di shard yang sama (misalnya shard tabel pesanan berdasarkan
user_idsehingga seluruh pesanan seorang user berada di satu shard).
4. Idempotensi: Mengatasi Jaringan yang Rentan Gangguan
Dalam arsitektur terdistribusi, jaringan internet sering memutus paket. Ketika client mengirim transaksi pembayaran lalu menerima pesan HTTP 504 Gateway Timeout, client tidak bisa mengetahui apakah server gagal memproses sebelum eksekusi, atau server sudah sukses memotong saldo namun paket respons balik terputus di tengah jalan.
Jika client secara membabi-buta mengulang (retry) permintaan tersebut, saldo pelanggan berisiko terpotong dua kali.
Implementasi Idempotensi Standar Enterprise:
- Aplikasi client selalu menghasilkan UUID unik pada header
Idempotency-Keyuntuk setiap operasi mutasi data. - Server backend menjalankan operasi pengecekan atomik di Redis (
SET key "PROCESSING" NX EX 120).- Jika kunci sudah ada dengan status
PROCESSING, kembalikan HTTP409 Conflict(permintaan sedang dalam proses). - Jika kunci sudah ada dengan status
COMPLETED, langsung kembalikan respons JSON yang tersimpan di cache tanpa menyentuh logika bisnis perbankan.
- Jika kunci sudah ada dengan status
- Database menetapkan aturan
UNIQUE(idempotency_key)pada tabel transaksi keuangan untuk mencegah kondisi balapan (race condition) di lapisan penyimpanan.
5. Pola Transaksi Terdistribusi: Outbox, Saga & CQRS
Pada arsitektur microservice, masing-masing layanan memiliki database terisolasi sendiri. Transaksi monolitik ACID lintas database tidak lagi dimungkinkan. Bagaimana menjaga konsistensi datanya?
Pola 1: Transactional Outbox Pattern (Menghilangkan Masalah Dual-Write)
CELAH BAHAYA DUAL-WRITE:
1. Service Order menulis data pesanan ke database PostgreSQL lokal.
2. Service Order mencoba mengirimkan event ke klaster Apache Kafka.
3. Klaster Kafka mendadak down atau timeout!
Akibat: Database memiliki data pesanan, tetapi Kafka tidak pernah menerima event. Sistem desinkronisasi!
Dengan menyimpan event ke dalam tabel outbox di dalam satu transaksi ACID lokal yang sama persis dengan penulisan entitas pesanan, kita menjamin secara matematis: jika pesanan berhasil tersimpan di DB, maka rekaman event outbox dipastikan ikut tersimpan. Komponen Change Data Capture (CDC seperti Debezium) membaca log biner WAL database dan mengalirkannya secara andal ke Kafka.
Pola 2: Saga Pattern (Transaksi Terdistribusi Tanpa 2PC)
Saga memecah satu transaksi bisnis besar yang panjang menjadi rangkaian transaksi lokal antarmicroservice. Apabila salah satu langkah mengalami kegagalan, Saga mengeksekusi Compensating Transactions (Transaksi Kompensasi) secara terbalik untuk membatalkan perubahan data sebelumnya.
Alur Sukses (Happy Path):
[ Buat Pesanan Pending ] ──► [ Kunci Stok Barang ] ──► [ Potong Saldo Bank ] ──► [ Pesanan Terkonfirmasi ]

Alur Gagal & Kompensasi:
[ Buat Pesanan Pending ] ──► [ Kunci Stok Barang ] ──► [ Saldo Gagal Debet! ]
                                       │
                                       ▼ Langkah Kompensasi Pembalik
                             [ Buka Kunci Stok ] ──► [ Tandai Pesanan Dibatalkan ]
Pendekatan Koreografi vs. Orkestrasi:
- Choreography (Koreografi Berbasis Event): Setiap service mendengarkan event Kafka dan memicu langkah berikutnya secara otonom. Cocok untuk alur sederhana (2–4 service). Kelemahan: Sulit dilacak dan didebug saat alur bisnis semakin kompleks (spaghetti events).
- Orchestration (Orkestrasi Terpusat): Satu service koordinator (misalnya Temporal, AWS Step Functions, atau engine orkestrator kustom) secara eksplisit memerintahkan setiap service langkah apa yang harus diambil selanjutnya dan melacak status Saga secara menyeluruh. Sangat disarankan untuk alur bisnis kritis perusahaan.
Pola 3: CQRS (Command Query Responsibility Segregation)
Pada sistem bertrafik masif, karakteristik beban penulisan (write) dan pembacaan (read) memiliki kebutuhan performa dan konsistensi yang sangat bertolak belakang (sering kali rasio perbandingannya adalah 99% baca, 1% tulis).
- Model Command: Menangani operasi tulis, memvalidasi aturan bisnis yang rumit, dan menyimpan data ke database relasional ternormalisasi (PostgreSQL).
- Model Query: Mengonsumsi event dari Kafka untuk memperbarui proyeksi tampilan yang telah dihitung sebelumnya (pre-computed views) pada Elasticsearch, MongoDB, atau Redis. Kueri pencarian dapat dieksekusi dalam hitungan milidetik tanpa membebani tabel relasional!
6. Distributed Rate Limiting: Melindungi API dari Ledakan Trafik
Rate limiting membatasi frekuensi request client untuk melindungi server dari serangan bot scraping, pencurian kredensial (credential stuffing), dan lonjakan trafik mendadak.
Implementasi Produksi: Skrip Lua Redis Sliding Window Counter
Pada klaster server API Gateway multi-node, perhitungan kuota harus bersifat atomik. Menjalankan beberapa perintah bolak-balik ke Redis secara terpisah akan memicu balapan data (race condition). Kita menyelesaikannya dengan mengeksekusi Skrip Lua Atomik langsung di dalam mesin Redis:
LUA
-- KEYS[1]: Kunci identitas rate limit (misal "ratelimit:user_123:minute")
-- ARGV[1]: Maksimal request yang diizinkan (misal 100)
-- ARGV[2]: Timestamp detik saat ini
-- ARGV[3]: Durasi jendela waktu dalam detik (misal 60)

local current = redis.call('GET', KEYS[1])
if current and tonumber(current) >= tonumber(ARGV[1]) then
    return 0 -- Kuota habis! Tolak request & return HTTP 429
else
    local count = redis.call('INCR', KEYS[1])
    if tonumber(count) == 1 then
        redis.call('EXPIRE', KEYS[1], ARGV[3])
    end
    return 1 -- Request diizinkan lewat
end
Karena mesin Redis mengeksekusi skrip Lua secara single-threaded, logika pemeriksaan kuota terjamin 100% atomik di hadapan ribuan koneksi konkuren.
Matriks Ketahanan Sistem: Ringkasan Pola Solusi
| Skenario Krisis | Solusi Arsitektural Terdistribusi |
|---|---|
| Kabel bawah laut putus membelah data center | Terapkan model AP (eventual consistency) atau tolak operasi tulis (CP). |
| Menambah server cache memicu badai eviksi | Consistent Hashing dengan virtual node untuk membatasi churn sebesar $1/N$. |
| Tabel transaksi melampaui 500 juta baris | Hash-Based Database Sharding dengan shard key berbasis ID user. |
| Jaringan putus saat memotong saldo pengguna | Client mengirimkan Idempotency-Key, server validasi status atomik di Redis. |
| Microservice crash di tengah alur checkout | Saga Pattern Orchestrator memicu langkah kompensasi pembalik secara terbalik. |
| Serangan bot scraping membanjiri server | Sliding Window Rate Limiter di API Gateway mengembalikan HTTP 429 Too Many Requests. |
Langkah Selanjutnya di Part 4
Kita telah menguasai fondasi jaringan, komponen fisik skalabilitas, dan pola arsitektur sistem terdistribusi. Sekarang saatnya menguji seluruh keahlian tersebut dalam simulasi wawancara nyata.
Di bagian penutup, Part 4: Studi Kasus Interview Nyata, kita akan merancang 5 sistem produksi nyata dari nol:
- Merancang Sistem Pemendek URL (TinyURL)
- Merancang Sistem Chat Real-Time (WhatsApp)
- Merancang Aplikasi Pesan Antar Makanan (Zomato / Gojek)
- Merancang Sistem Notifikasi Skala Masif
- Merancang Distributed Rate Limiter